Domain instandhalten.de kaufen?
Wir ziehen mit dem Projekt
instandhalten.de um.
Sind Sie am Kauf der Domain
instandhalten.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain instandhalten.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Donner, Jochen: E-MTB: Wartung, Pflege & ReparaturE-MTB: Wartung, Pflege & Reparatur , Sitzposition, Motor, Schaltung, Bremsen, Federung, Laufräder , Befestigungs- & Spanngurte > Transportsysteme , Auflage: Nachdruck, Erscheinungsjahr: 20180319, Produktform: Kartoniert, Autoren: Donner, Jochen~Simon, Daniel, Auflage/Ausgabe: Nachdruck, Seitenzahl/Blattzahl: 143, Abbildungen: 200 farbige Fotos, Keyword: elektrofahrrad; e mountainbike; e mtb; e bike mountainbike; e bike mtb; elektrorad; mtb e bike; elektrovelo; mountain e bike; e mountain bike, Fachschema: E-Bike - Pedelec~Fahrrad / Mountain-Bike~Mountain-Bike~Fahrrad - Rad~Velociped~Fahrzeug - Fahrzeugbau - Fahrzeugtechnik, Fachkategorie: Fahrräder und nicht-motorisierte Verkehrsmittel: Ratgeber, Sachbuch (Wartung)~Radfahren: Allgemein und Touring~Motorsport, Radsport, Vehikelsport, Thema: Orientieren, Warengruppe: HC/Fahrrad, Fachkategorie: Wartung und Instandhaltung von Fahrzeugen und Handbuch, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Delius Klasing Vlg GmbH, Verlag: Delius Klasing Vlg GmbH, Verlag: Delius Klasing, Länge: 241, Breite: 166, Höhe: 12, Gewicht: 415, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber, Herkunftsland: SLOWAKEI (SK), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0025, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 176062622,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
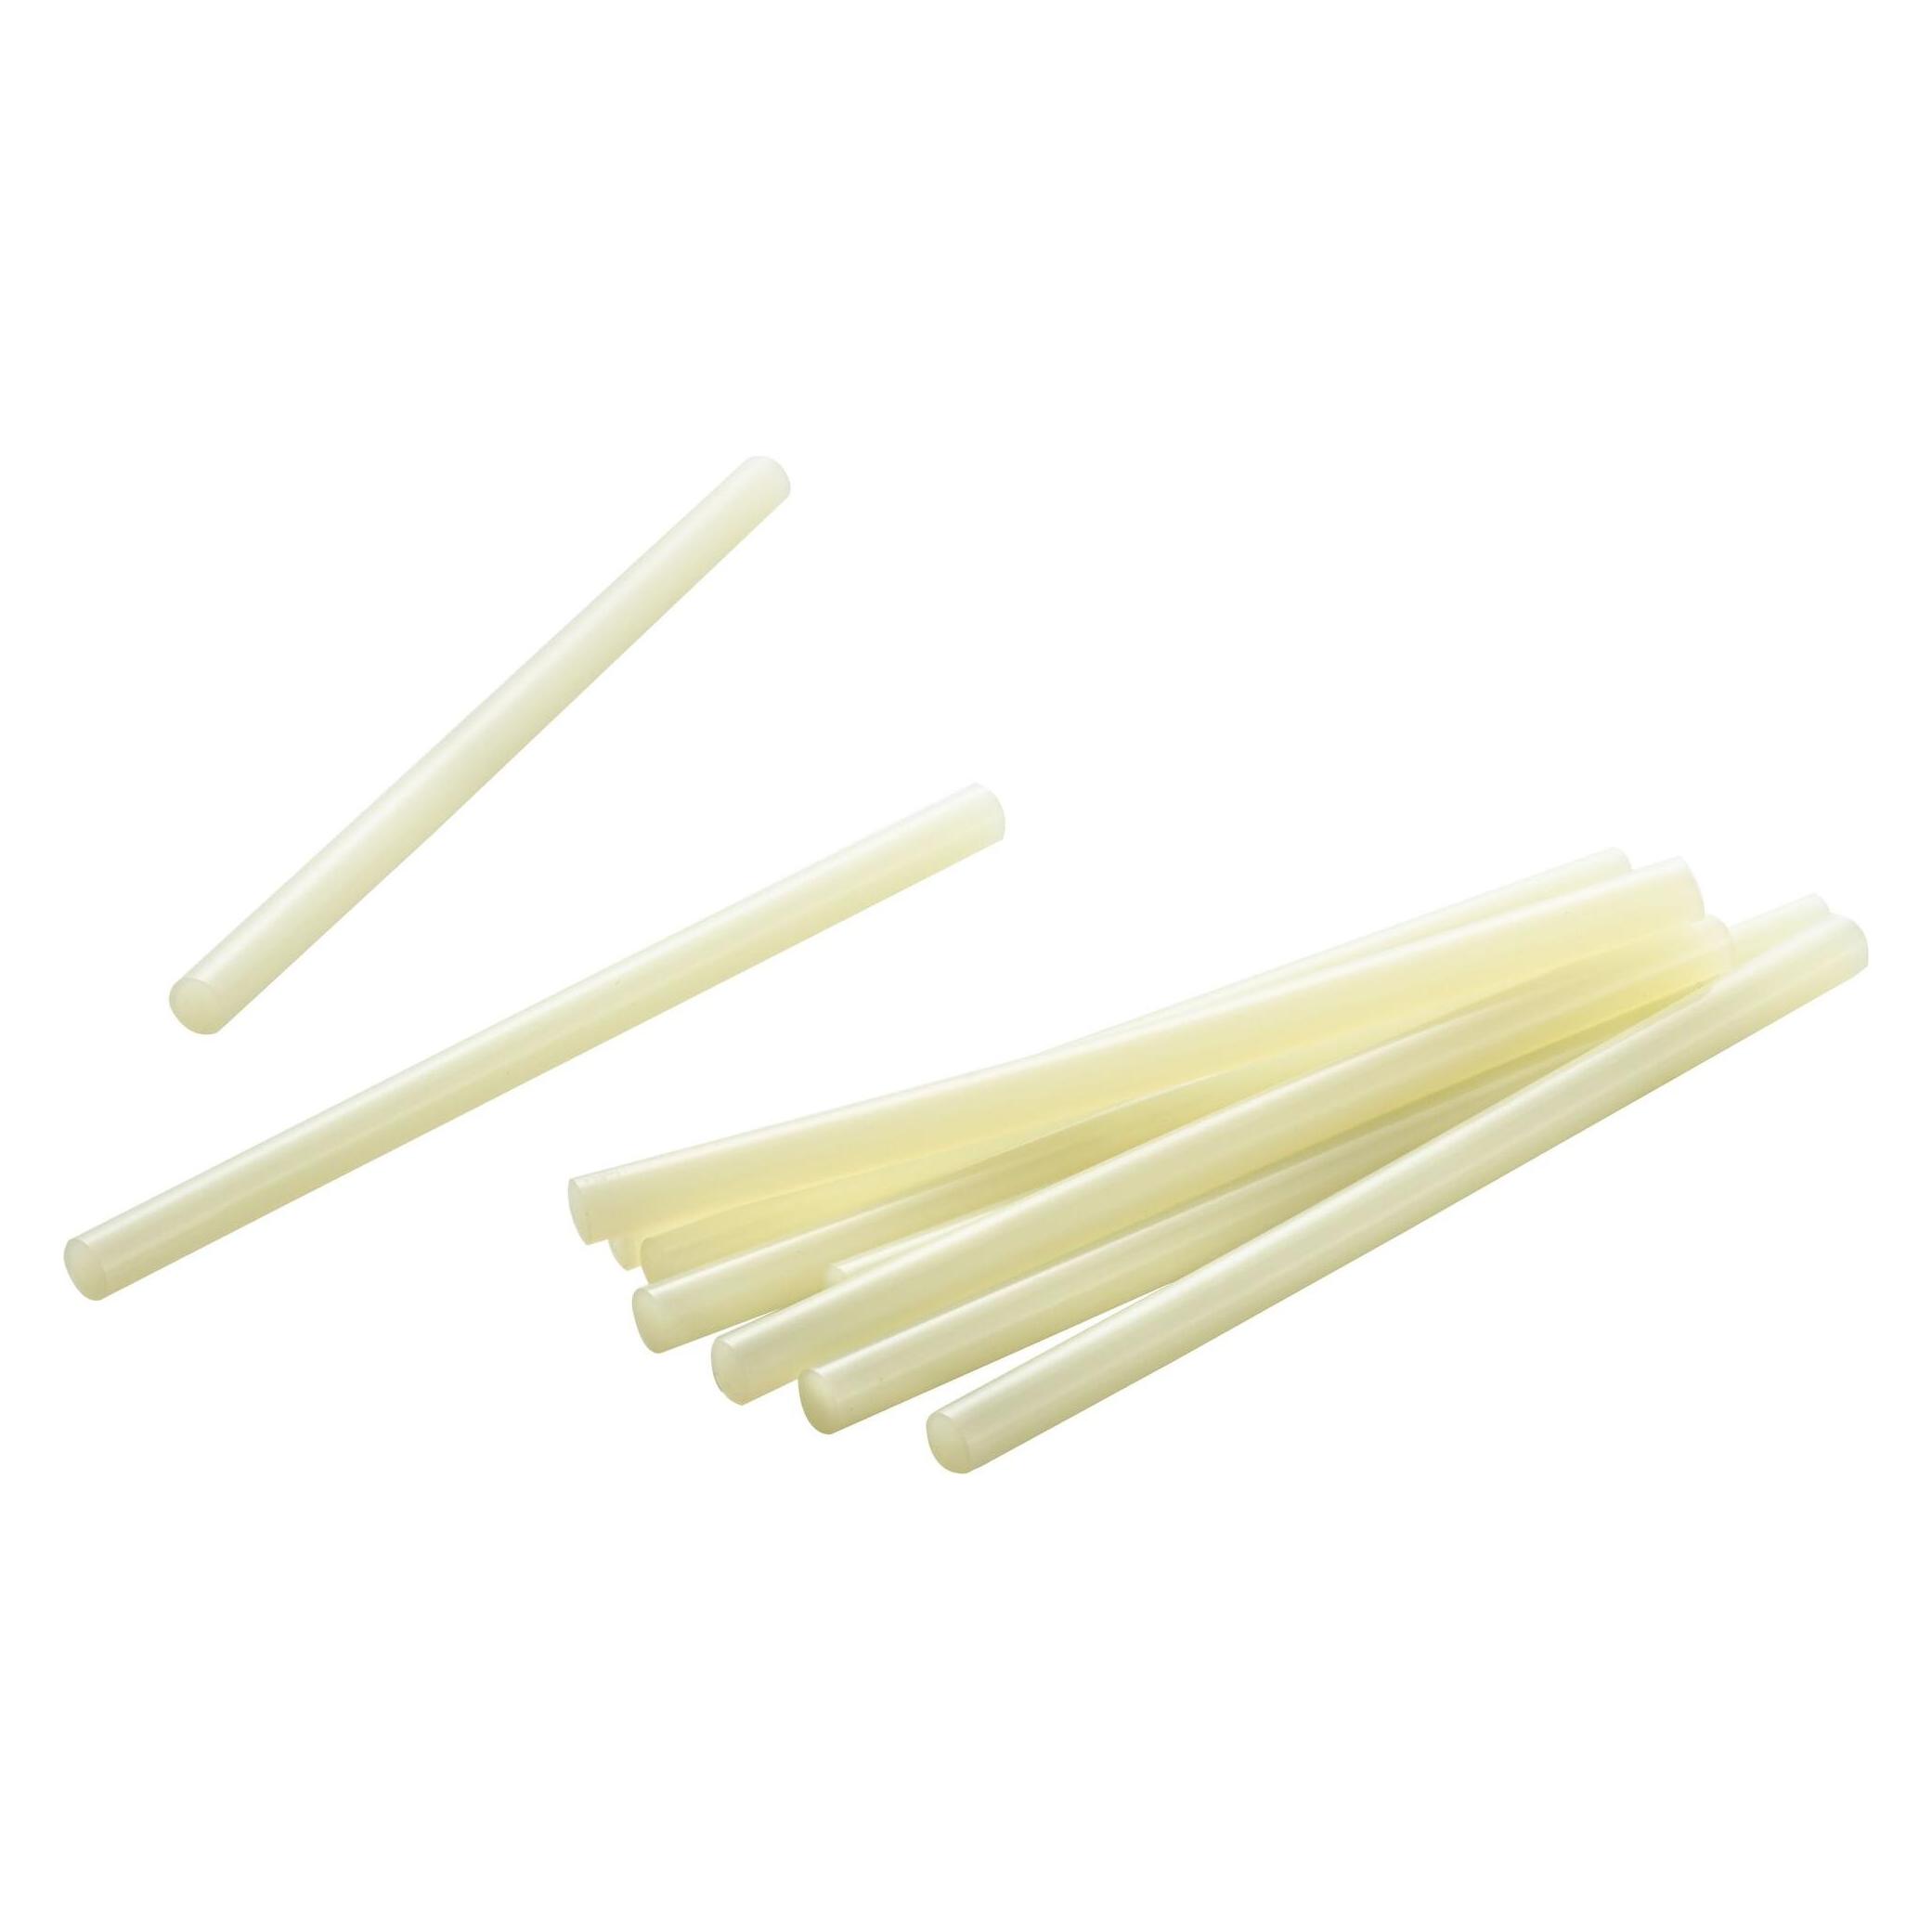
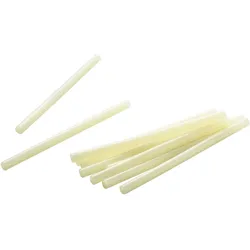
Facom, Heisskleber, Wartung, InstandsetzungProduktstärken: Kleber auf Basis von thermoplastischen Polymeren. Für die Verwendung mit einer FACOM Heisskleberpistole E.900A oder einem gleichwertigen Modell. Stäbe Ø 11 mm x 198 mm. Geeignet für die Beseitigung von Dellen an Karosserien. Reinigung mit Isopropylalkohol. Verpackt in Kartons zu 1 kg. Garantieumfang: L.58,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **

Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Donner, Jochen: E-MTB: Wartung, Pflege & ReparaturE-MTB: Wartung, Pflege & Reparatur , Sitzposition, Motor, Schaltung, Bremsen, Federung, Laufräder , Befestigungs- & Spanngurte > Transportsysteme , Auflage: Nachdruck, Erscheinungsjahr: 20180319, Produktform: Kartoniert, Autoren: Donner, Jochen~Simon, Daniel, Auflage/Ausgabe: Nachdruck, Seitenzahl/Blattzahl: 143, Abbildungen: 200 farbige Fotos, Keyword: elektrofahrrad; e mountainbike; e mtb; e bike mountainbike; e bike mtb; elektrorad; mtb e bike; elektrovelo; mountain e bike; e mountain bike, Fachschema: E-Bike - Pedelec~Fahrrad / Mountain-Bike~Mountain-Bike~Fahrrad - Rad~Velociped~Fahrzeug - Fahrzeugbau - Fahrzeugtechnik, Fachkategorie: Fahrräder und nicht-motorisierte Verkehrsmittel: Ratgeber, Sachbuch (Wartung)~Radfahren: Allgemein und Touring~Motorsport, Radsport, Vehikelsport, Thema: Orientieren, Warengruppe: HC/Fahrrad, Fachkategorie: Wartung und Instandhaltung von Fahrzeugen und Handbuch, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Delius Klasing Vlg GmbH, Verlag: Delius Klasing Vlg GmbH, Verlag: Delius Klasing, Länge: 241, Breite: 166, Höhe: 12, Gewicht: 415, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber, Herkunftsland: SLOWAKEI (SK), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0025, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 176062622,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Ähnliche Suchbegriffe für Datenquellen
-
Facom, Heisskleber, Wartung, InstandsetzungProduktstärken: Kleber auf Basis von thermoplastischen Polymeren. Für die Verwendung mit einer FACOM Heisskleberpistole E.900A oder einem gleichwertigen Modell. Stäbe Ø 11 mm x 198 mm. Geeignet für die Beseitigung von Dellen an Karosserien. Reinigung mit Isopropylalkohol. Verpackt in Kartons zu 1 kg. Garantieumfang: L.58,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.